Respuesta rápida:La IA de código abierto puede ofrecer más opciones de despliegue y control de datos, pero no garantiza menor coste total, mejor rendimiento regional ni el cierre de la brecha de inversión. Compara calidad, seguridad, latencia, capacidades internas y coste de extremo a extremo sobre la misma carga.
La brecha de inversión no explica por sí sola sus causas
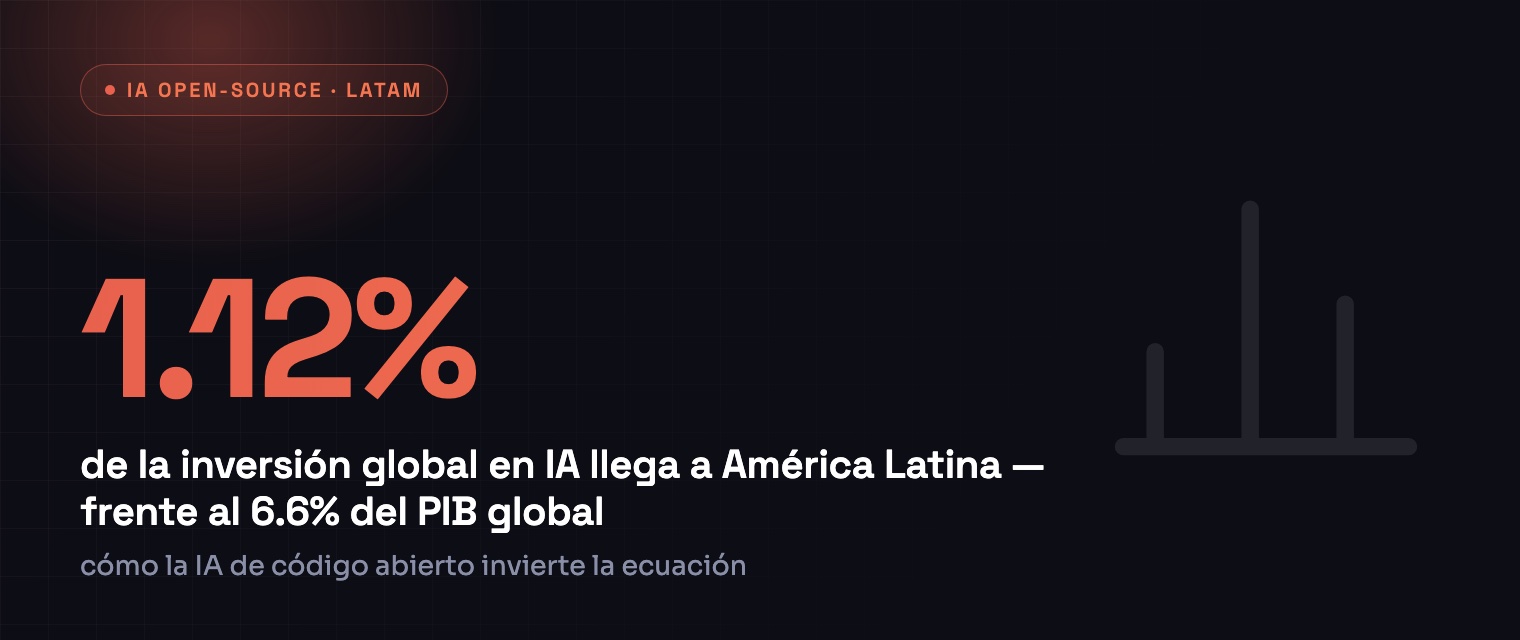
CEPAL y el Índice Latinoamericano de Inteligencia Artificial 2025 informan que los 19 países analizados representan el 6,6% del PIB mundial pero reciben el 1,12% de la inversión global en IA. La comparación establece un desequilibrio de inversión. No identifica por sí sola una causa única ni demuestra que el código abierto vaya a cerrarlo.
Hay tres mecanismos que conviene medir en lugar de asumir: precios en dólares frente a presupuestos locales, disponibilidad y latencia de infraestructura, y calidad del modelo en el idioma y la tarea regionales. Su peso cambiará por país, sector y carga de trabajo.
Para una pyme, la decisión no es “abierto frente a propietario” en abstracto. Compara la misma tarea entre las opciones disponibles. Incluye suscripción o uso, integración, hosting, tiempo del equipo, revisión de seguridad, gestión de fallos y soporte.
El ajuste lingüístico también exige evaluación directa. Construye un conjunto de pruebas con preguntas, documentos y terminología reales del mercado objetivo. Informa por locale y tarea. Un modelo global puede rendir bien y uno regional puede fallar. La etiqueta no responde la pregunta de rendimiento.
El Código Abierto Cambia el Modelo de Costes, No Siempre el Coste Total
Los modelos de pesos abiertos pueden eliminar tarifas por token y permitir alojamiento propio, pero añaden infraestructura, ingeniería, monitorización, seguridad y soporte. No existe un ahorro universal de 5 a 7 veces. El resultado cambia con el tamaño del modelo, uso, latencia, carga, región cloud y capacidad del equipo.
Compara la misma carga representativa en APIs y despliegues abiertos. Mide calidad, tasa de fallos, latencia, rendimiento, tiempo del personal, hosting, observabilidad, revisión de seguridad y mantenimiento. Un modelo abierto pequeño puede ganar una tarea y perder otra.
El procesamiento de documentos, el soporte sobre catálogos y el análisis de demanda son candidatos plausibles para una prueba. Que un despliegue de pesos abiertos resulte asequible depende del volumen, la precisión requerida, las capacidades disponibles, el hosting y el coste de revisión humana. Trátalos como comparaciones de carga, no como ahorros prometidos.
El alojamiento propio puede ofrecer mayor control sobre dónde se procesan los datos, pero solo si logs, proveedores, copias de seguridad, accesos y procesos operativos están configurados en consecuencia. Los pesos abiertos no crean privacidad o seguridad automáticamente.
Los modelos de pesos abiertos también admiten ajuste fino y despliegue local. Hay que comprobar si la mejora justifica el coste de datos y mantenimiento frente a alternativas más simples como RAG, prompting o un modelo gestionado.
El Rendimiento Lingüístico Regional Debe Medirse
La calidad puede variar por variante lingüística, dominio y tarea. Eso exige conjuntos de evaluación con entradas regionales reales, no asumir que todo modelo global falla o que todo modelo regional rinde mejor.
El lenguaje operativo cambia entre México, Colombia, Perú, Argentina, Brasil y las numerosas comunidades de la región. La pregunta relevante es si el modelo maneja vocabulario, contexto factual, requisitos de seguridad e instrucciones de la tarea en el mercado objetivo. Revisores nativos e inputs reales ofrecen una respuesta más sólida que las suposiciones sobre el origen del modelo.
La cuestión lingüística va más allá del español y el portugués. El Banco Mundial estima 42 millones de personas indígenas en América Latina, y la cobertura lingüística regional varía mucho. En servicios públicos, bancarios o esenciales, prueba el acceso y la finalización de tareas con las comunidades afectadas, en lugar de usar el español estándar como sustituto suficiente.
La cultura no debe reducirse a estereotipos regionales. Evalúa los comportamientos que importan para el servicio: terminología, cortesía, escalado, regulación local, exactitud factual y finalización de tareas. Segmenta los resultados por mercado en lugar de atribuir una sola cultura comercial a América Latina.
Evalúa terminología, exactitud factual, seguridad, tono y finalización de tareas con revisores del mercado objetivo. Informa por locale y caso de uso. Las afirmaciones culturales generales no sustituyen esa medición.
Latam-GPT representa una arquitectura regional de IA, no solo un modelo
LatamGPT-SFT 1.0 está disponible con pesos abiertos bajo la licencia comunitaria Llama 3.1. Su ficha indica español, portugués e inglés y unos 297.000 millones de tokens en Corpus 1.0. Evalúa esta versión en tu tarea; no demuestra rendimiento en otras lenguas ni superioridad frente a alternativas.
La pregunta técnica central es si el corpus regional mejora el rendimiento en tareas regionales. El tamaño del corpus no basta para responderla. Hace falta documentación del modelo, gobernanza de datos, benchmarks independientes por locale y tarea, evaluación de seguridad y licencias claras.
La construcción de datos regionales es importante, pero el tamaño y origen del corpus no prueban la calidad final. Antes de afirmar superioridad hacen falta benchmarks independientes, documentación, licencias y evaluaciones de seguridad y tareas.
La estructura colaborativa de la iniciativa, que reúne universidades, instituciones de investigación y organizaciones tecnológicas de varios países, es en sí misma significativa. Refleja la comprensión de que la soberanía digital en IA no puede lograrla un solo país de la región por su cuenta. Brasil, México, Colombia, Argentina y Perú tienen perfiles lingüísticos y comerciales distintos. Un modelo panregional requiere alianzas panregionales de datos, y la confianza institucional para compartir corpus propietarios en favor de un bien público compartido.
LatamGPT-SFT 1.0 está disponible con pesos abiertos bajo la licencia comunitaria Llama 3.1. Su ficha indica español, portugués e inglés y unos 297.000 millones de tokens en Corpus 1.0. Evalúa esta versión en tu tarea; no demuestra rendimiento en otras lenguas ni superioridad frente a alternativas.
Tres aplicaciones donde las pymes latinoamericanas pueden desplegar IA de código abierto hoy
Las pymes no necesitan esperar a un modelo fundacional regional para probar casos acotados. Atención al cliente, documentos y previsión son candidatos para evaluar, no despliegues con ROI garantizado.
Atención al cliente. Prueba un conjunto acotado de intenciones de bajo riesgo con escalado humano. Compara resolución, exactitud, satisfacción, latencia y coste antes de ampliar.
Operaciones documentales. Evalúa extracción y clasificación sobre una muestra etiquetada de facturas, contratos o declaraciones reales. Mantén revisión humana en decisiones materiales y calcula el coste con tasas de error y tiempo medidos.
Análisis de demanda y cadena de suministro. Compara el modelo con una línea base estadística simple sobre datos históricos. Usa backtesting y restricciones de negocio antes de permitir que una recomendación afecte inventario o compras.
El hilo común es la evaluación. Elige el modelo y despliegue más pequeños que cumplan umbrales definidos de calidad, riesgo, latencia y coste. La opción ganadora puede ser abierta, propietaria o híbrida.
Qué Puede y Qué No Puede Resolver el Código Abierto
El código abierto puede mejorar la elección de despliegue, inspección, personalización y capacidad local. No aporta por sí solo inversión, infraestructura fiable, datos representativos, equipos cualificados, gobierno o instituciones sostenibles.
La distinción útil está entre desplegar modelos creados fuera e invertir en datos, investigación y talento regionales. Cada camino tiene costes y dependencias distintos. Ninguno cierra automáticamente las brechas de inversión, idioma o capacidad.
La soberanía digital es una cuestión de política y economía sobre control, dependencia, interoperabilidad y capacidad institucional. La infraestructura regional puede reducir algunas dependencias, pero también crea costes y responsabilidades. Ese balance debe evaluarse, no darse por garantizado por una licencia abierta.
Las pymes pueden actuar sin esperar a que se cierre la brecha regional de inversión. Un piloto acotado puede comprobar si un sistema abierto, propietario o híbrido desarrolla capacidad interna útil y cumple un umbral de negocio definido. Cualquier ventaja duradera debe demostrarse en operaciones, no suponerse por la licencia.
La oportunidad existe ahora. La estadística del 1,12% es una restricción sobre el capital, no sobre la inteligencia, la iniciativa ni la disposición a construir.
Preguntas frecuentes
La IA de código abierto y los modelos de pesos abiertos abarcan licencias y grados distintos de acceso. Algunos pueden alojarse o ajustarse, pero varían el coste total, la seguridad y los requisitos operativos.
CEPAL informó que los 19 países cubiertos por el ILIA 2025 representaban el 6,6% del PIB mundial, pero recibían el 1,12% de la inversión global en IA. La comparación documenta una brecha de inversión, pero no establece por sí sola sus causas ni cuantifica sus efectos empresariales.
No existe un múltiplo universal de ahorro. Compara calidad y coste de extremo a extremo sobre la misma carga, incluido hosting, ingeniería, seguridad, monitorización, soporte y precios de API.
Los modelos globales de IA están entrenados predominantemente con datos en inglés, con el español como lengua secundaria, y aun así, con el español castellano del contenido web europeo más que con las variantes mexicana, argentina o colombiana que se usan en el comercio. Los modelos tienen competencia mínima en lenguas indígenas como el quechua y el náhuatl, y suelen interpretar mal la jerga regional, los modismos culturales y la terminología de mercado. El resultado son salidas que van desde lo torpe hasta lo factualmente incorrecto cuando se aplican al contexto empresarial latinoamericano.
LatamGPT-SFT 1.0 está disponible con pesos abiertos bajo la licencia comunitaria Llama 3.1. Su ficha indica español, portugués e inglés y unos 297.000 millones de tokens en Corpus 1.0. Evalúa esta versión en tu tarea; no demuestra rendimiento en otras lenguas ni superioridad frente a alternativas.
La soberanía digital es una cuestión política y económica sobre control, dependencia, interoperabilidad, datos y capacidad institucional. La infraestructura regional puede reducir algunas dependencias y añadir costes y responsabilidad operativa. Una licencia abierta no resuelve el balance.
Atención al cliente, documentos y previsión son candidatos para pruebas acotadas. Define una línea base y compara calidad, fallos, latencia, tiempo del personal, riesgo y coste total antes de ampliar.
Las pymes deben comparar sistemas abiertos, propietarios e híbridos sobre una carga acotada. Mide calidad, tasa de fallos, latencia, tiempo del equipo, riesgo y coste total. El efecto sobre productividad o competitividad debe demostrarse en operaciones, no inferirse de la licencia.
 FA
¿Estás llevando IA a los mercados latinoamericanos?
Fernando Angulo asesora a empresas globales y organizaciones regionales sobre estrategia de adopción de IA, inteligencia digital de mercado y el futuro de la búsqueda.